2026年11月11日,MiniMax 正式开源发布图像生成模型 H3-Image。作为一款拥有 33.1B 参数的扩散 Transformer(DiT)模型,H3-Image 支持原生 4K 超高清图像生成,兼具快速生成与精准指令遵循能力,支持文生图、参考图生成和图像编辑,并开放全部模型权重。
后摩智能已于模型开源首日完成 H3-Image 的 Day-0 适配,自研后摩漫界 M50 存算一体芯片已成功跑通该模型,相关性能仍在持续优化中。
Day 0适配:从模型开源到芯片跑通
Day-0 适配并非简单地将模型部署到芯片上。从模型权重发布到芯片端完整运行,需要完成算子支持、图编译、精度校验、运行时适配与性能调优等一系列工作。对于多模态模型,还需要打通视觉与语言等不同模块之间的协同链路。
这背后,既需要成熟的软件工具链提供支撑,也考验芯片架构、编译优化与模型适配团队的协同能力。后摩智能能够快速响应主流开源模型迭代,正是长期积累的端边 AI 软硬件协同能力的体现。
模型亮点:原生4K,兼具画质、速度与可控性
H3-Image 不仅将图像生成分辨率提升至 4K,也在生成效率、指令理解和多图参考等方面进行了优化,主要有三个看点:
原生 4K 直出:支持最高 4096×4096 分辨率图像生成,无需额外超分放大,单张图像生成时间控制在 10 秒以内,官方数据显示生成速度约为主流方案的 5 倍。
精准指令遵循:具备较强的复杂指令理解能力,支持最多 16 张参考图输入,可在同一套模型权重下完成文生图、参考图生成与图像编辑。
完整开放模型权重:与 H3 一样开放全部权重,为开发者提供模型部署、定制和二次开发的灵活空间。
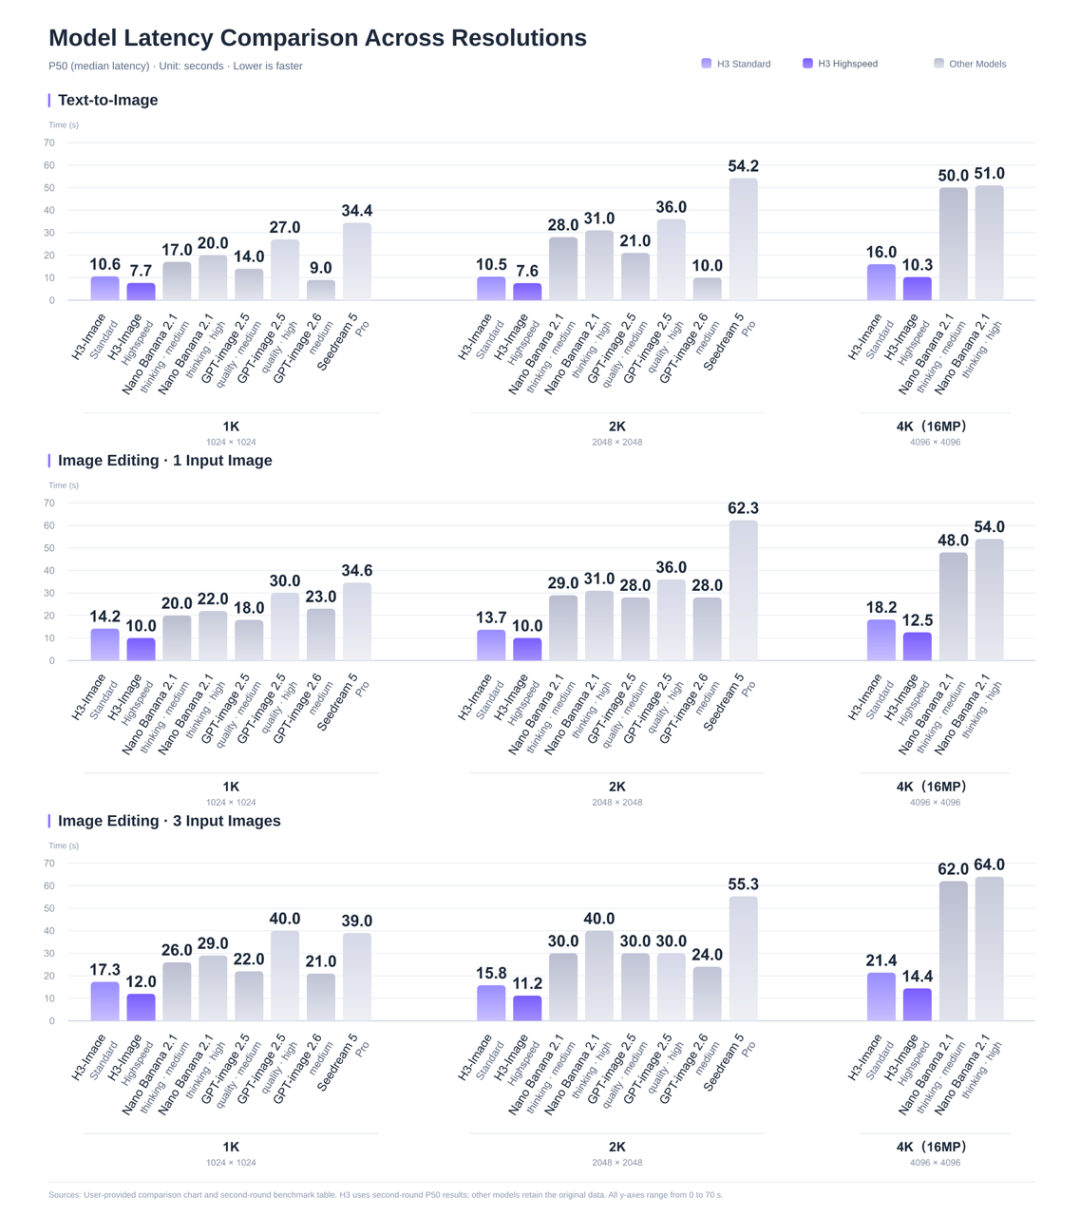
(H3-Image 不同分辨率下的生成时延对比)
核心架构与技术参数:
DiT 主体(33.1B 参数):采用 50 层稠密单流结构,隐藏维度 5376、56 个注意力头,并使用 3D 多模态 RoPE 位置编码。
文本编码器(Qwen3-VL):沿用 H3 使用的文本编码器,负责中英文提示词理解与编码。
混合图像 VAE:采用 16 倍空间下采样,包含 24 个潜在通道。
高效推理设计:采用 2×2 Patch 化,每个 Token 对应 32×32 像素区域,并通过蒸馏将采样步数压缩至 6 步,无需 CFG,在保障生成效果的同时降低推理计算开销。
M50产品能力:让大模型图像生成走向端边部署
后摩漫界 M50 是后摩智能面向端侧与边缘场景推出的量产存算一体 AI 芯片。凭借高能效算力与大容量内存支持,M50 能够为大参数模型的本地化部署提供算力基础。
M50 核心参数:
在软件适配层面,后摩智能此前已围绕 H3 建立 Attention、GEMM 等核心算子,以及通信、运行时等基础设施。本次针对 H3-Image 的模型结构与推理负载,进一步完成注意力机制、多参考图生成等关键环节的适配与优化,实现从模型加载、编译到推理运行的全链路打通。
完成适配后,相关编译产物可结合 llama.cpp、vLLM、SGLang 等推理引擎,进一步封装为标准化 API 服务,便于开发者集成与部署。
从边缘终端到服务器,M50 提供多种硬件形态:
边缘端 M.2 卡:LM5010(160 TOPS)/ LM5020 Duo(320 TOPS)
服务器端 PCIe 卡:LM5030(160 TOPS)/ LM5070(640 TOPS,最高支持 192GB 内存、614.4 GB/s 带宽)
针对不同的应用需求,H3-Image 既可部署于单卡 M50,也可扩展至4×M50 集群,总算力达 640 TOPS,满足更高并发的图像生成任务需求,为不同规模的本地化 AI 图像生成应用提供部署选择。
持续拓展开源模型生态,释放端边AI创新潜力
从图像生成到视频生成,后摩智能持续推进主流开源模型的芯片适配。此前,M50 已完成Qwen-Image 2.1 图像生成模型与 MiniMax H3 视频生成模型的 Day-0 适配。本次 H3-Image 的成功跑通,进一步拓展了 M50 在高分辨率图像生成领域的模型支持能力。
从文生图到文生视频,从单卡部署到多卡扩展,后摩智能正持续完善面向开源多模态模型的软硬件适配能力,让更多大模型能够在端侧与边缘设备上高效运行。
欢迎开发者基于后摩漫界M50及4×M50 算力平台部署体验 H3-Image,共同探索端边 AI 图像生成的更多应用可能。
推荐阅读: